Di 2023 semua orang belajar "prompt engineering": mencari kalimat ajaib agar model menjawab lebih baik. Di 2025–2026, praktisi AI mulai memakai istilah yang lebih tepat: context engineering — seni dan ilmu menyusun seluruh informasi yang masuk ke jendela konteks model, bukan hanya satu kalimat instruksi.
Apa Bedanya?
Prompt engineering bertanya: "Kalimat apa yang harus saya tulis?"
Context engineering bertanya: "Informasi apa yang perlu model lihat — dan apa yang tidak — agar bisa menyelesaikan tugas ini?"
Model modern sudah sangat pintar mengikuti instruksi. Kegagalan agent AI sekarang lebih sering disebabkan oleh konteks yang buruk: informasi kurang, terlalu banyak sampah, atau instruksi yang saling bertentangan.
Prinsip 1: Konteks Adalah Anggaran
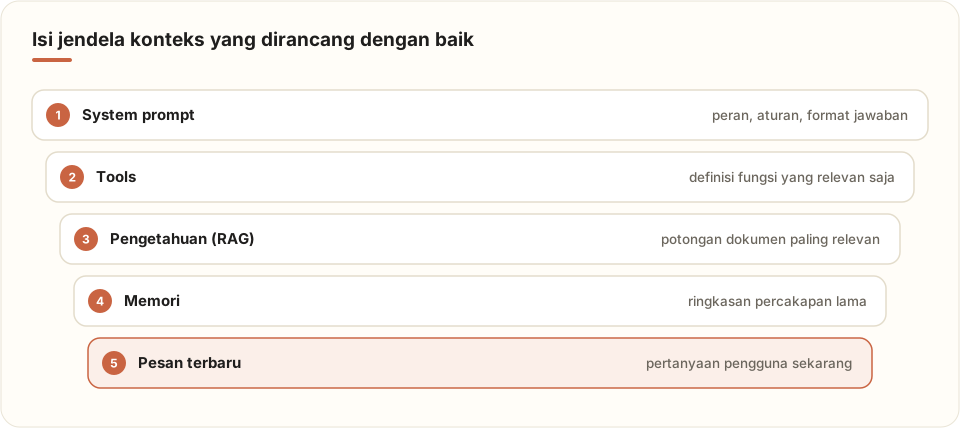
Jendela konteks besar bukan berarti boleh diisi apa saja. Semakin banyak token tidak relevan, semakin besar peluang model "terdistraksi" — fenomena yang sering disebut context rot. Perlakukan token seperti anggaran:
import anthropic

client = anthropic.Anthropic()

def hitung_token(messages, system=""):
    hasil = client.messages.count_tokens(
        model="claude-sonnet-5-5",
        system=system,
        messages=messages,
    )
    return hasil.input_tokens

print(hitung_token([{"role": "user", "content": "Halo!"}]))
Prinsip 2: Ambil Hanya yang Relevan (RAG)
Alih-alih menempelkan seluruh dokumentasi, ambil potongan paling relevan:
def susun_konteks(pertanyaan: str, cari_dokumen, batas_token: int = 4000) -> str:
    potongan = cari_dokumen(pertanyaan, top_k=8)   # hasil pencarian semantik
    terpilih, total = [], 0
    for p in potongan:
        est = len(p["teks"]) // 4                   # estimasi kasar 1 token ~ 4 karakter
        if total + est > batas_token:
            break
        terpilih.append(f"<dokumen sumber='{p['sumber']}'>\n{p['teks']}\n</dokumen>")
        total += est
    return "\n\n".join(terpilih)
Membungkus dokumen dengan tag seperti <dokumen> membantu model membedakan data dari instruksi — ini juga mengurangi risiko prompt injection.
Prinsip 3: Ringkas Memori Lama
Percakapan panjang bisa diringkas secara berkala agar tetap muat:
def ringkas_jika_panjang(riwayat: list[dict], maks_pesan: int = 20) -> list[dict]:
    if len(riwayat) <= maks_pesan:
        return riwayat
    lama, baru = riwayat[:-10], riwayat[-10:]
    teks_lama = "\n".join(f"{m['role']}: {m['content']}" for m in lama)
    ringkasan = client.messages.create(
        model="claude-haiku-5-5",
        max_tokens=500,
        messages=[{"role": "user", "content":
            f"Ringkas poin penting percakapan berikut dalam 5 butir:\n{teks_lama}"}],
    ).content[0].text
    return [{"role": "user", "content": f"Ringkasan percakapan sebelumnya:\n{ringkasan}"},
            {"role": "assistant", "content": "Baik, saya ingat konteksnya."}] + baru
Perhatikan pemakaian model kecil (Haiku) untuk tugas ringkas — hemat biaya tanpa mengorbankan kualitas jawaban utama.
Prinsip 4: Tools yang Sedikit tapi Jelas
Memberi agent 50 tools sekaligus justru membingungkan. Pilih tools sesuai tugas, beri nama dan deskripsi yang tegas:
tools = [{
    "name": "cari_pesanan",
    "description": "Cari pesanan berdasarkan nomor invoice (format INV-XXXX). "
                   "Gunakan HANYA jika pengguna menyebut nomor invoice.",
    "input_schema": {
        "type": "object",
        "properties": {"invoice": {"type": "string", "pattern": "^INV-[0-9]{4}$"}},
        "required": ["invoice"],
    },
}]
Prinsip 5: Struktur System Prompt
| Bagian | Isi |
|---|---|
| Peran | "Kamu adalah asisten CS toko X" |
| Tujuan | Apa yang dianggap berhasil |
| Aturan | Batasan tegas (apa yang tidak boleh) |
| Format | Panjang, bahasa, struktur jawaban |
| Contoh | 1–3 contoh pasangan tanya-jawab yang ideal |
Penutup
Prompt yang bagus tetap penting, tapi ia hanya satu lapisan. Hasil terbaik datang dari konteks yang dirancang: relevan, ringkas, terstruktur, dan diukur. Mulailah dengan menghitung token, membuang yang tidak perlu, dan memisahkan data dari instruksi — perbedaannya akan langsung terasa.

0 Komentar