Pencarian LIKE '%kata%' punya keterbatasan besar: mencari "cara deploy aplikasi" tidak akan menemukan artikel berjudul "Panduan Rilis ke Server Production". Pencarian semantik menyelesaikan masalah ini dengan membandingkan makna, bukan huruf. Kabar baiknya, di 2026 kamu tidak perlu menambah database baru — pgvector membuat PostgreSQL bisa melakukannya.
Konsep Singkat: Embedding
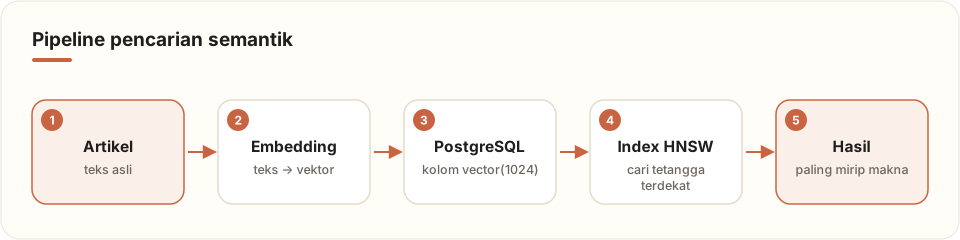
Embedding adalah representasi teks dalam bentuk deretan angka (vektor). Teks dengan makna mirip akan menghasilkan vektor yang berdekatan. Jarak antar vektor diukur dengan cosine distance.
Setup pgvector
# Docker: image resmi sudah menyertakan pgvector
docker run -d --name pg -e POSTGRES_PASSWORD=rahasia -p 5432:5432 pgvector/pgvector:pg17
CREATE EXTENSION IF NOT EXISTS vector;
CREATE TABLE artikel (
id BIGSERIAL PRIMARY KEY,
judul TEXT NOT NULL,
isi TEXT NOT NULL,
embedding vector(1024)
);
-- Index HNSW untuk pencarian cepat berbasis cosine distance
CREATE INDEX ON artikel USING hnsw (embedding vector_cosine_ops);Angka 1024 harus sama dengan dimensi model embedding yang kamu pakai.
Membuat Embedding
Contoh berikut memakai model embedding melalui API (Voyage AI). Kamu juga bisa memakai model lokal seperti yang tersedia di Ollama.
# embed.py
import os, psycopg
import voyageai
from pgvector.psycopg import register_vector

vo = voyageai.Client(api_key=os.environ["VOYAGE_API_KEY"])

def embed(teks: list[str], tipe: str = "document") -> list[list[float]]:
    return vo.embed(teks, model="voyage-3.5", input_type=tipe).embeddings

with psycopg.connect("postgresql://postgres:rahasia@localhost/postgres") as conn:
    register_vector(conn)
    rows = conn.execute("SELECT id, judul, isi FROM artikel WHERE embedding IS NULL").fetchall()
    for batch in [rows[i:i+64] for i in range(0, len(rows), 64)]:
        vektor = embed([f"{r[1]}\n\n{r[2][:6000]}" for r in batch])
        for (id_, _, _), v in zip(batch, vektor):
            conn.execute("UPDATE artikel SET embedding = %s WHERE id = %s", (v, id_))
    conn.commit()
Mencari Berdasarkan Makna
def cari(pertanyaan: str, k: int = 5):
    q = embed([pertanyaan], tipe="query")[0]
    with psycopg.connect(DSN) as conn:
        register_vector(conn)
        return conn.execute(
            """SELECT judul, 1 - (embedding <=> %s) AS kemiripan
               FROM artikel
               ORDER BY embedding <=> %s
               LIMIT %s""",
            (q, q, k),
        ).fetchall()

for judul, skor in cari("cara rilis aplikasi ke server"):
    print(f"{skor:.3f}  {judul}")
Operator <=> adalah cosine distance. Semakin kecil jaraknya, semakin mirip maknanya.
Hybrid Search: Gabungkan dengan Full-Text
Pencarian semantik kadang kurang tepat untuk istilah spesifik (nama fungsi, kode error). Solusinya: gabungkan dengan full-text search bawaan PostgreSQL.
WITH semantik AS (
  SELECT id, ROW_NUMBER() OVER (ORDER BY embedding <=> $1) AS r
  FROM artikel ORDER BY embedding <=> $1 LIMIT 20
), kata_kunci AS (
  SELECT id, ROW_NUMBER() OVER (ORDER BY ts_rank(to_tsvector('simple', isi), q) DESC) AS r
  FROM artikel, plainto_tsquery('simple', $2) q
  WHERE to_tsvector('simple', isi) @@ q LIMIT 20
)
SELECT a.judul,
       COALESCE(1.0/(60 + s.r), 0) + COALESCE(1.0/(60 + k.r), 0) AS skor
FROM artikel a
LEFT JOIN semantik s ON s.id = a.id
LEFT JOIN kata_kunci k ON k.id = a.id
WHERE s.id IS NOT NULL OR k.id IS NOT NULL
ORDER BY skor DESC LIMIT 5;
Teknik ini disebut Reciprocal Rank Fusion (RRF) — sederhana tapi sangat efektif.
Tips Performa
- Gunakan
halfvecuntuk menghemat setengah ruang penyimpanan jika presisi penuh tidak dibutuhkan. - Atur
SET hnsw.ef_search = 100;untuk menaikkan akurasi dengan sedikit biaya kecepatan. - Potong (chunk) dokumen panjang menjadi bagian 300–800 kata agar hasil lebih presisi.
Penutup
pgvector membuktikan bahwa "tambah fitur AI" tidak selalu berarti "tambah infrastruktur". Jika aplikasimu sudah memakai PostgreSQL, pencarian semantik tinggal satu ekstensi lagi. Mulai dari tabel kecil, ukur relevansinya, lalu kembangkan menjadi hybrid search.
0 Komentar